Te ofrecen un lakehouse, tu equipo de datos quiere un data lake y la gerencia solo pide que los reportes cuadren. Antes de elegir, conviene saber qué resuelve cada arquitectura, en qué se diferencian y en qué casos el modelo clásico sigue siendo la mejor opción.
La pregunta no es cuál es más moderna, sino cuál responde mejor a los datos que tiene hoy tu empresa. En Aleph Server partimos por la opción más simple y solo sumamos piezas cuando el problema lo exige.
Data warehouse
Un data warehouse es un repositorio centralizado de información estructurada, organizado para responder preguntas de negocio. Los datos se limpian y se modelan antes de entrar: primero se define cómo serán las tablas y después se cargan solo datos que calcen con ellas. Quien consulta encuentra cifras consistentes y comparables.
Un caso típico es el de una empresa cuyo ERP, CRM y sistema de facturación alimentan cada noche un modelo de ventas por cliente, producto y mes, que usa la gerencia comercial. Su fortaleza es la consistencia: hay una sola definición de «venta» o de «cliente activo». Su límite aparece cuando la empresa quiere sumar datos que no calzan con ese modelo, como los comentarios de clientes en el CRM, los correos de reclamos o las planillas que envían los distribuidores, cada una con su formato, o cuando cambiar el modelo obliga a reprocesar el historial.
Data lake
El término lo acuñó en 2010 James Dixon, entonces CTO de Pentaho, con una analogía: un data mart es agua embotellada, lista para el consumo, y un data lake es un cuerpo de agua en estado natural. El lago guarda los datos tal como llegan, en su formato original y a bajo costo, y se decide cómo interpretarlos al usarlos.
Un ejemplo es conservar los archivos que exportan todos los sistemas de la empresa, más correos y PDF, para que el área de analítica los explore. Gana en flexibilidad y costo. Su riesgo es conocido: sin catálogo, calidad mínima ni responsables, el lago se vuelve un pantano de datos donde se guarda todo y no se encuentra nada. Además, por sí solo no evita que dos procesos que escriben a la vez dejen datos inconsistentes.
Lakehouse
El concepto lo formalizó en 2021 un equipo de Databricks en la conferencia académica CIDR. Su diagnóstico: mantener un lago más un warehouse es complejo, los datos llegan con retraso al warehouse y el almacenamiento se paga dos veces.
La propuesta es guardar los datos en almacenamiento barato con formatos abiertos, como Apache Parquet, y agregar encima una capa de tablas que aporte transacciones ACID, versionado y gobernanza.
ACID es la sigla de atomicidad, consistencia, aislamiento y durabilidad. En simple: una operación se aplica completa o no se aplica, y dos procesos que escriben al mismo tiempo no se pisan. Es lo que un lago por sí solo no ofrece.
Delta Lake y Apache Iceberg son las dos alternativas más usadas para esa capa, ambas open source: resuelven lo mismo y se elige una.
Una advertencia: Databricks comercializa estas tecnologías y el benchmark del artículo es de un solo proveedor. La propuesta es coherente, pero esas cifras no son una validación independiente.
En el mercado, Snowflake, BigQuery y Redshift nacieron como warehouses en la nube; Databricks ofrece un lakehouse administrado, y también se puede montar uno con componentes abiertos en infraestructura propia, como el que se muestra al final.
Las tres en una tabla
| Aspecto | Data warehouse | Data lake | Lakehouse |
| Qué guarda | Datos estructurados y modelados | Datos de cualquier tipo, en su formato original | Datos de cualquier tipo, con tablas transaccionales encima |
| Cuándo se ordenan | Antes de guardarlos | Al momento de usarlos | Por capas: primero crudos, luego refinados |
| Transacciones y consistencia | Sí, de forma nativa | No, por sí solo | Sí, mediante la capa de tablas |
| Uso principal | Reportes e indicadores | Exploración y ciencia de datos | Reportes y ciencia de datos sobre la misma copia |
| Riesgo principal | Rigidez ante datos nuevos | Pantano de datos | Más piezas que operar |
Cuándo basta un warehouse clásico
Un lakehouse no es una mejora automática. Un warehouse clásico, o incluso una base de datos relacional bien modelada con una herramienta de reportes, suele ser la mejor decisión cuando se dan estas condiciones.
- Los datos vienen de pocos sistemas y son casi todos tabulares.
- Los reportes son estables y el equipo conoce SQL.
- No hay necesidad de explorar datos no estructurados ni de entrenar modelos.
- El equipo es pequeño y no puede operar varias piezas de infraestructura.
En esos casos, sumar un lago o un lakehouse agrega componentes que mantener sin resolver un problema que la empresa tenga hoy.
Preguntas para decidir
- ¿Qué tipos de datos tengo hoy y cuáles espero tener en doce meses?
- ¿Quién consume los datos: solo reportes, o también ciencia de datos y modelos?
- ¿Qué tan seguido cambian las fuentes y sus formatos?
- ¿Quién va a operar la plataforma y con qué capacidad?
- ¿Cuánto cuesta equivocarme, es decir, cambiar de arquitectura más adelante?
Si las respuestas apuntan a reportes sobre datos estructurados, lo razonable es partir por un warehouse. Si aparecen datos variados y casos de ciencia de datos, vale la pena evaluar un lago o un lakehouse.
VektralForge: un lakehouse abierto para probar
Si quieres ver un lakehouse funcionando, prueba VektralForge, un proyecto open source (licencia Apache 2.0) patrocinado por Aleph Server. Reúne Apache Airflow, Apache Spark, Delta Lake, Trino y Apache Superset en un stack que se levanta con Docker Compose.
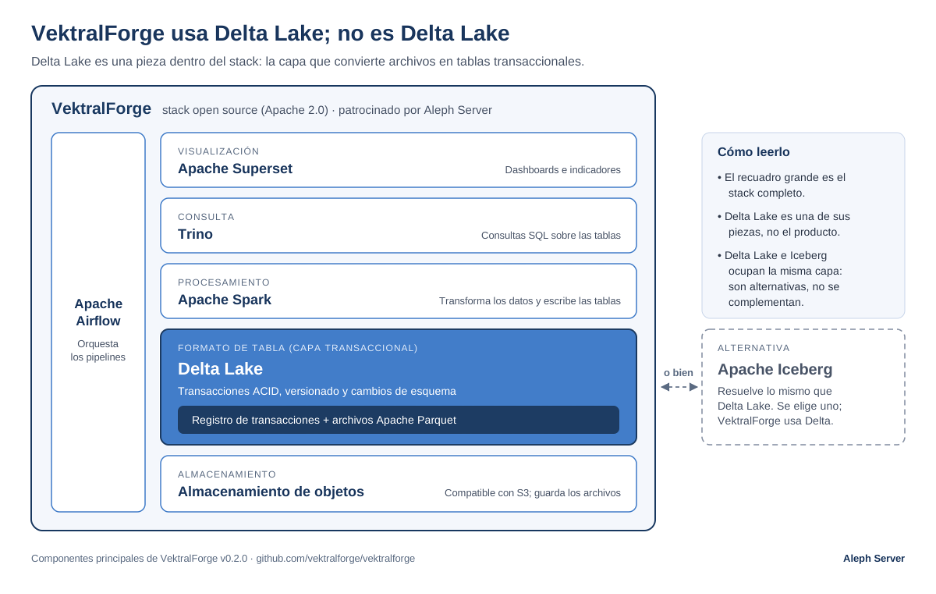
VektralForge usa Delta Lake como capa de tablas; Apache Iceberg sería la alternativa para esa misma capa.
Incluye un pipeline de indicadores financieros: descarga los valores de mindicador.cl, guarda la respuesta cruda en la zona raw y la lleva a tablas Delta tipadas en la capa bronze, que se consultan con SQL sobre los mismos archivos, sin copiarlos a otro sistema.
No es la única forma de armar un lakehouse ni la adecuada para todas las empresas: es un punto de partida abierto. Va en la versión 0.2.0 y su despliegue a producción está planificado. Código y documentación: github.com/vektralforge/vektralforge y vektralforge.org.
Siguiente paso
Si estás evaluando una de estas arquitecturas, en Aleph Server te ayudamos a responder esas cinco preguntas con tus datos reales. Y si la respuesta es un lakehouse, lo dejamos funcionando en producción y a tu equipo preparado para operarlo.